Wer Inhalte modelliert, bevor sie geschrieben werden, entscheidet über Konsistenz, Skalierbarkeit und Sichtbarkeit, auf jedem Kanal.
Die wichtigste redaktionelle Entscheidung fällt, bevor jemand den ersten Satz tippt. Sie betrifft, noch vor Überschrift, Teaser und Bild, die Frage, was ein Inhalt ist: welche Bestandteile er hat, wie sie zusammenhängen und wo sie enden. Diese Entscheidung heißt Content Modeling.
Content Modeling bedeutet, Inhalte in Typen, Felder und Beziehungen zu zerlegen. Ein Rezept ist eine Kombination aus Zutatenliste, Zubereitungsschritten, Nährwertangaben und einem Bild. Ein Produkttext ist ein Zusammenspiel aus Name, Beschreibung, technischen Daten, Preis und Verfügbarkeit. Das Modell definiert, welche Elemente existieren, welche Regeln gelten und wie sich die Teile zueinander verhalten.
Rosenfeld, Morville und Arango haben dafür den Begriff der Informationsatome geprägt: die kleinsten sinnvollen Einheiten, in die sich Inhalt zerlegen lässt. Wie fein diese Atome geschnitten sind, bestimmt, was mit Inhalten später möglich ist. Es ist eine Vorentscheidung. Genau das macht sie so mächtig und so unsichtbar zugleich.
Content Modeling passiert vor der redaktionellen Arbeit. Es ist die Architektur hinter der Eingabemaske, die Logik hinter dem Dropdown, die Struktur hinter dem Feldsatz. Contentful beschreibt das Modell als Fundament: Es bestimme, welche Inhalte die Schnittstellen ausliefern. Wer ein CMS öffnet und Felder sieht, blickt auf das Ergebnis eines Modellierungsprozesses. Meistens, ohne es zu wissen.
Historisch war das anders. Inhalt und Darstellung waren untrennbar. Rosenfeld und Morville nennen das tight coupling. Digitale Systeme lösen diese Kopplung auf. Content wird vom gebundenen Artefakt zur Information, die unabhängig vom Ausgabekanal existiert. Diese Entkopplung ist die Voraussetzung dafür, dass derselbe Inhalt auf Website, App, Sprachschnittstelle und Print-Katalog funktioniert.
Der Unterschied zur Datenmodellierung in der klassischen Softwareentwicklung liegt vor allem in der Perspektive. Datenmodelle beschreiben, wie Systeme Informationen speichern und verarbeiten. Content Models beschreiben, wie Menschen Inhalte erstellen, pflegen und ausspielen. Wer nur das eine kennt, baut ein Modell, das technisch korrekt und redaktionell unbenutzbar ist.
Ein gutes Content Model löst ein konkretes Problem: Es macht Inhalte wiederverwendbar, ohne sie beliebig zu machen. Es schafft Konsistenz, ohne Kreativität zu ersticken. Und es denkt in Strukturen, die Menschen wie Maschinen lesen können.
Ein Inhalt, viele Ausgaben. Wiederverwendbarkeit ist eine ökonomische Notwendigkeit. Wenn ein Produkttext einmal modelliert ist (mit klar definierten Feldern für Kurzbeschreibung, technische Spezifikation, Anwendungshinweis), dann lässt sich dieser Text auf der Produktseite, im Newsletter, in der App und im Printkatalog verwenden. Ohne Copy-Paste, ohne Doppelpflege, ohne die stille Hoffnung, dass jemand daran denkt, alle Varianten zu aktualisieren. Oatly hat auf dieser Basis 16 Websites in zwei Monaten gelauncht, durch wiederverwendbare Inhaltsbausteine, die redaktionelle Teams unabhängig vom Entwicklungsteam einsetzten.
Strukturelle Regeln ersetzen redaktionelle Konventionen. Konsistenz entsteht in den meisten Organisationen durch Styleguides, Absprachen und Hoffnung. Ein Content Model verlagert sie dorthin, wo sie hingehört: in die Struktur. Teasertext auf 160 Zeichen begrenzt. Event-Typ enthält Datum, Ort, Beschreibung. Autorenreferenz ist ein Verweis auf ein gepflegtes Objekt. Die Konsistenz kommt aus der Architektur.
Maschinenlesbarkeit als Voraussetzung. Strukturierte Inhalte sind für Menschen klarer und zugleich die Grundlage dafür, dass Suchmaschinen, KI-Systeme und APIs Inhalte verstehen und verarbeiten können. Ein Freitextblock mit 500 Wörtern ist für eine Maschine Rauschen. Ein strukturiertes Objekt mit Feldern, Typen und Relationen ist ein Signal. Der Unterschied zeigt sich in der Sichtbarkeit und in der Anschlussfähigkeit an Systeme, die heute bereits Inhalte kuratieren, empfehlen und generieren.
Kanalagnostik als Designprinzip. 47 Prozent der Unternehmen betreiben bereits zwei bis drei CMS parallel, 27 Prozent sogar vier bis fünf, so der Storyblok State of CMS Report 2024. Kanalagnostik ist in dieser Realität schon heute Schadensbegrenzung. Ein gutes Content Model ist unabhängig vom Ausgabekanal. Es beschreibt, was ein Inhalt ist. Wie er aussieht, entscheidet der Kanal.
Die ökonomische Realität. Wer nach dem Business Case fragt, bekommt ihn. Forrester hat ihn 2022 für Contentstack berechnet: 295 Prozent ROI. 90 Prozent weniger Time-to-publish. 80 Prozent weniger Entwicklerzeit für Inhalte. Bei Virgin Media O2 entfiel manueller Aufwand von zwanzig Minuten pro Seite. Rakesh Radhakrishnan beziffert die Einsparung im mehrstelligen Millionenbereich. Jedes Jahr.
„Composable-Projekte scheitern selten an Software. Sie scheitern an einer Entscheidung, die ein halbes Jahr vor dem Launch getroffen wird — meist von der falschen Person, in zu kurzer Zeit. Diese Entscheidung heißt Content Modeling. Sie ist der unsichtbarste Hebel im Programm. Und der teuerste, wenn er kippt.“
– Hagen Seidel, Geschäftsführer Triplesense Reply, Partner bei Reply
Diese Zahlen beschreiben den Wert einer Struktur. Ein durchdachtes Modell ist ein Skalierungsmultiplikator. Ein fehlendes Modell eine Opex-Steuer, die mit jedem neuen Kanal, jedem neuen Markt, jeder neuen Sprache wächst.
Ein Muster wiederholt sich in fast jeder Organisation: Die Probleme mit Inhalten werden in der Redaktion sichtbar. Sie entstehen in der Architektur. Wer die typischen Fehler kennt, vermeidet sie. Wer sie ignoriert, zahlt exponentiell mehr für jede spätere Korrektur.
Der erste und häufigste Fehler ist Seitendenken. Inhalte werden als Seiten modelliert. Eine Homepage ist dann ein monolithischer Block mit Feldern wie „Headertext“, „Mittlerer Bereich“ und „Footer-Inhalt“, wo eigentlich Hero-Element, Teaser-Karussell und Eventliste als eigene Objekte zusammenspielen könnten. Das funktioniert genau so lange, wie sich niemand wünscht, denselben Inhalt an einer zweiten Stelle zu verwenden. Air France-KLM hat dieses Problem jahrelang erlebt. Lydie Rodrigues, Solution Manager for Content, beschrieb, dass eine einzige Wortänderung bis zu zwei Wochen dauern konnte. Zwei Wochen für ein Wort, und die Redaktion konnte nichts dafür. Die Ursache war ein Modell, das Inhalte an Seiten kettete, statt sie als eigenständige Objekte zu behandeln. Die Lösung: Inhalte in kleinere Bausteine zerlegen, wie Legosteine, die sich frei kombinieren lassen. Die projizierten Effekte: 50 Prozent niedrigere Entwicklungskosten, 20 Prozent weniger Service-Line-Calls, 15 Prozent weniger Übersetzungskosten.
Der zweite Fehler ist Überstrukturierung. Zu viele Felder, zu feine Granularität, zu wenig Spielraum. Ein Content-Typ mit 40 Pflichtfeldern ist am Ende nur noch ein Formular. Die Eingabemaske wird zur Bürokratie, die redaktionelle Geschwindigkeit bricht ein, und die Akzeptanz im Team sinkt auf null. 44 Prozent der Befragten im Storyblok State of CMS Report 2024 benennen die Schwierigkeit nichttechnischer Nutzer:innen, eigenständig Inhalte zu ändern, als zentrale Herausforderung. Das ist ein Modellierungsproblem, auch wenn es zuerst in der Oberfläche auffällt.
Der dritte Fehler ist das Gegenteil: Unterstrukturierung. Ein Rich-Text-Feld, in das alles passt. Überschriften, Bilder, Tabellen, eingebettete Videos: alles in einem einzigen Freitext-Blob. Die Eingabe fühlt sich frei an. Aber jede Automatisierung, jede Wiederverwendung, jede maschinelle Auswertung scheitert an der fehlenden Struktur. Der Inhalt existiert, aber er ist gefangen in einem Format, das nur ein Mensch auf genau einem Kanal lesen kann.
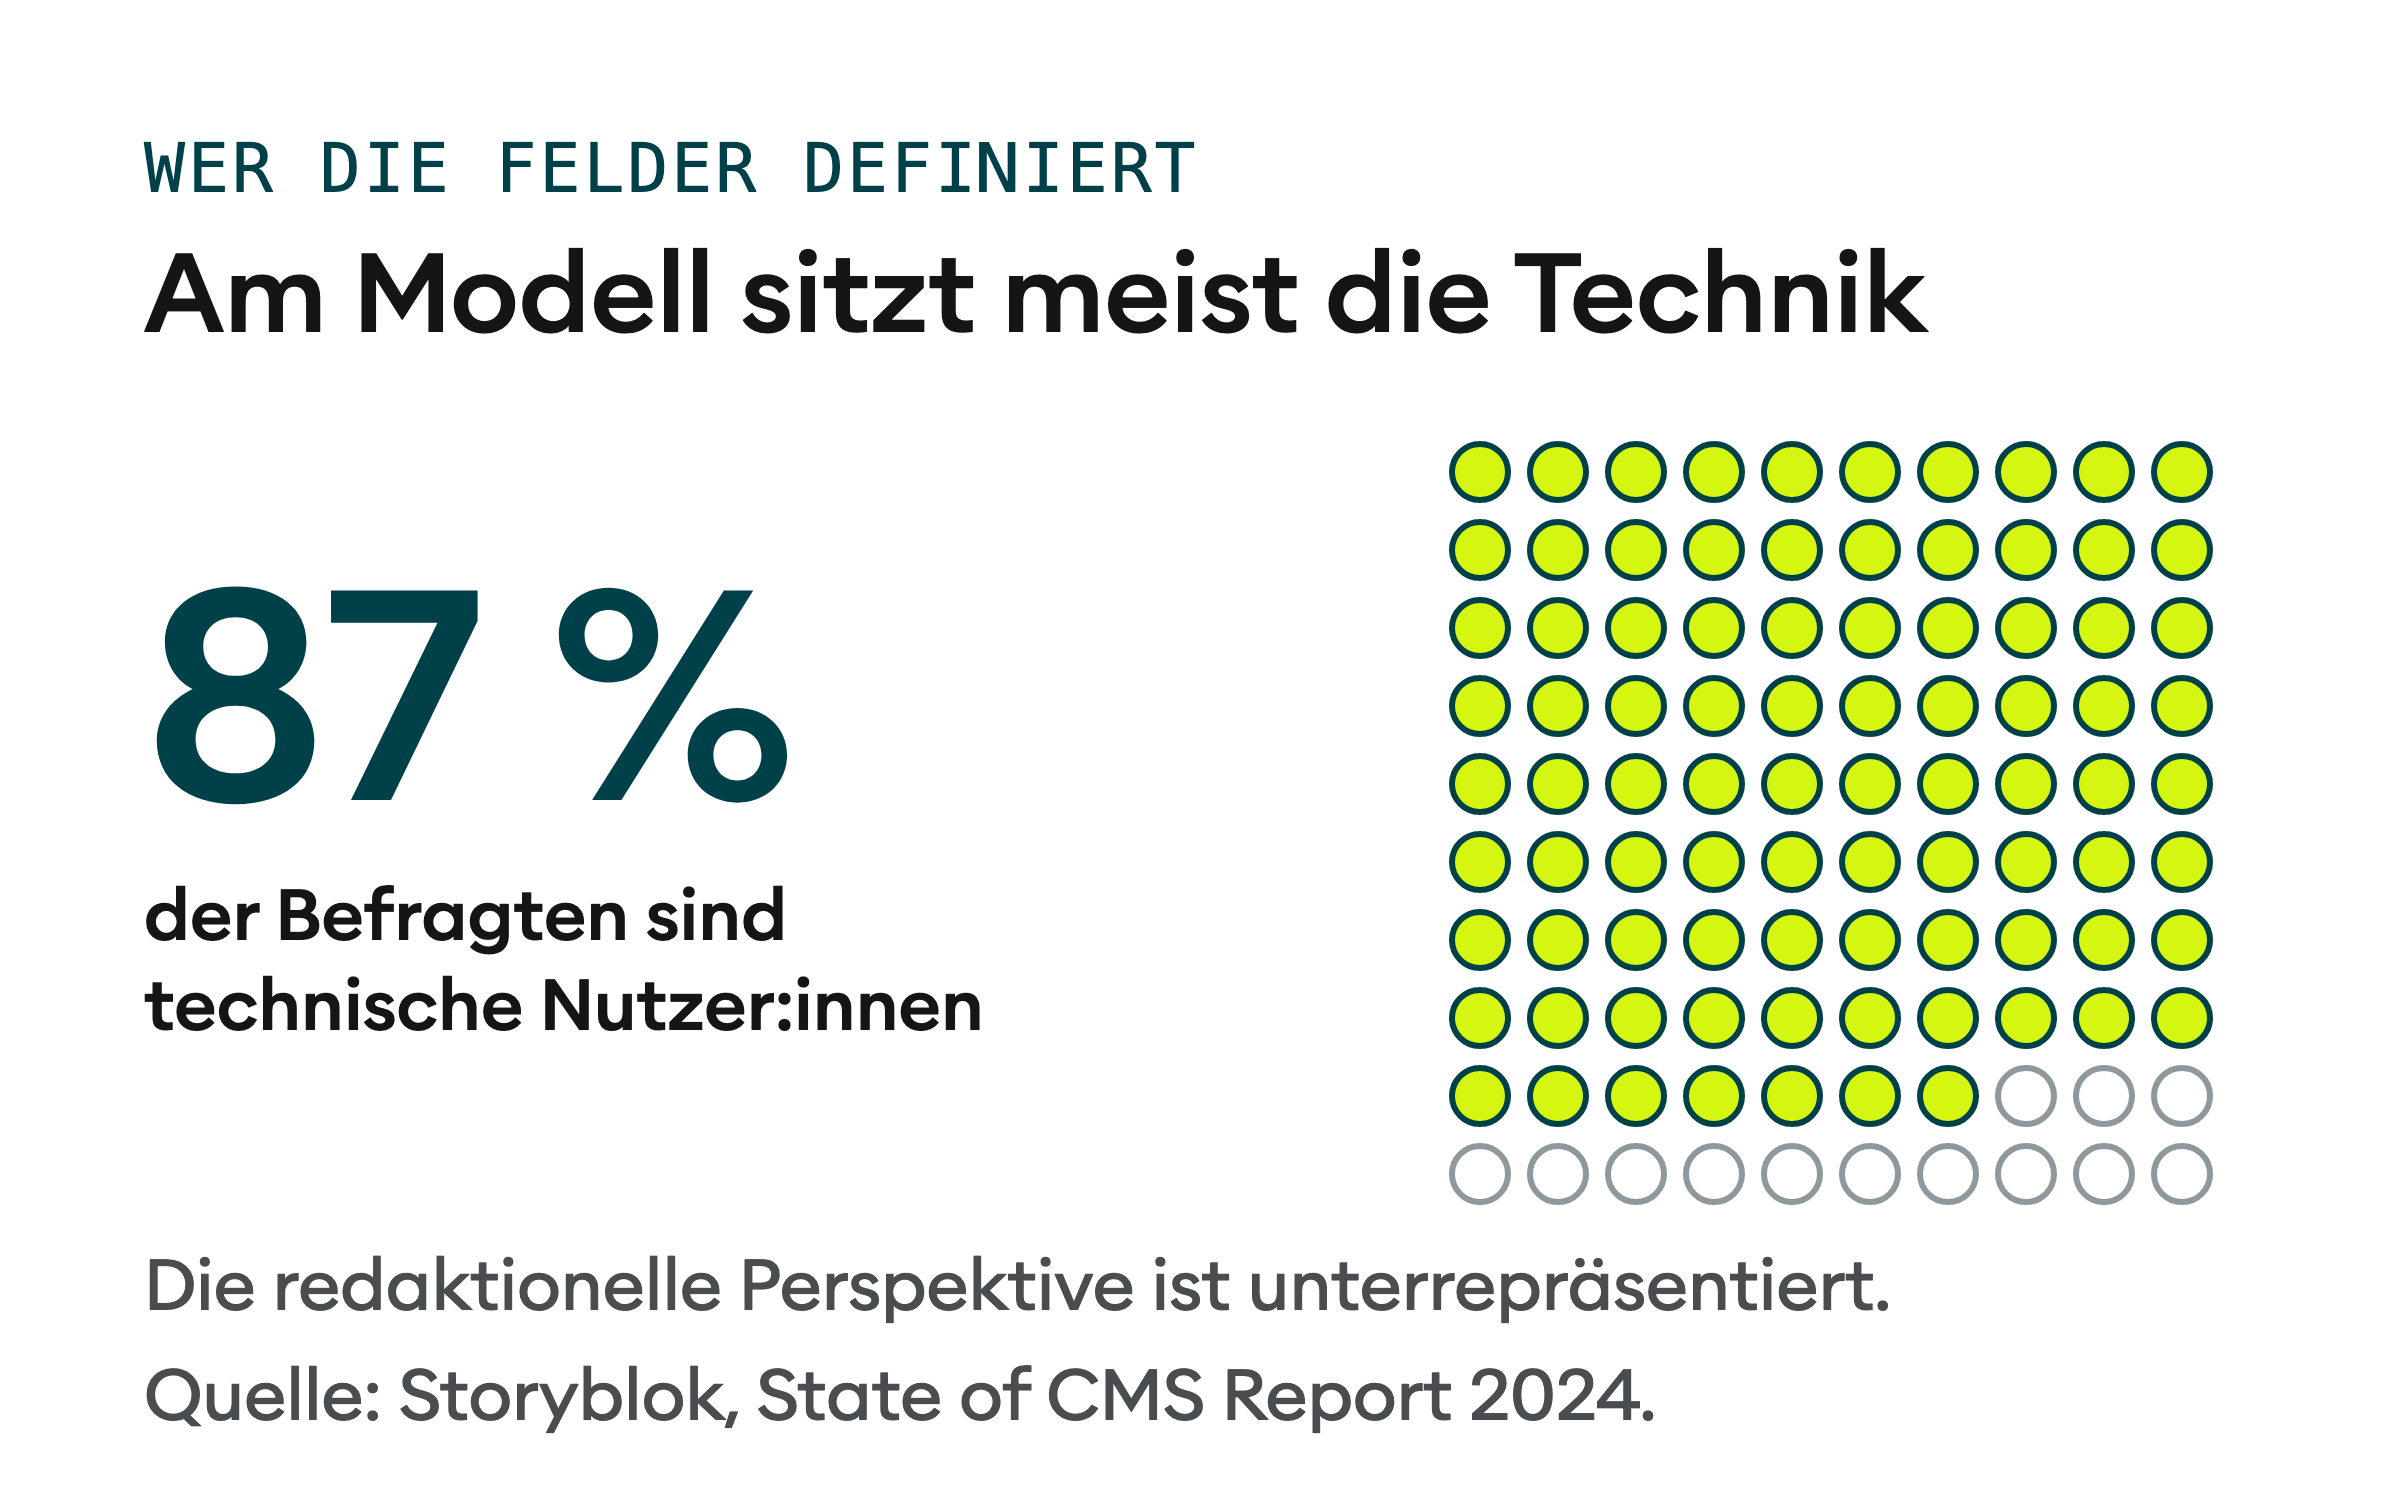
Der vierte und strukturell schwerwiegendste Fehler ist Modellierung ohne Redaktion. In vielen Organisationen treffen Entwicklungsteams die Entscheidungen über Content-Typen und Feldstrukturen. Das liegt schlicht daran, dass sie die Systeme bauen und jemand die Felder definieren muss. Die Storyblok-Erhebung zeigt das Problem in einer Zahl: 87 Prozent der Befragten sind technische Nutzer:innen. Die redaktionelle Perspektive ist unterrepräsentiert, in der Forschung wie in der Praxis. Das Ergebnis kennt jedes Content-Team: Ein CMS, das technisch sauber ist und redaktionell nicht funktioniert. Felder, die niemand versteht. Strukturen, die den Workflow behindern, statt ihn zu tragen. Fehlende Zusammenarbeit führt laut Storyblok-Report zu ungeordneten Inhalten, ineffizienten Abläufen und Ressourcenverschwendung.
Der Business Case des Fehlers ist simpel: Refactoring ist exponentiell teurer als initiale Planung. Wer ein Content Model nach dem Launch umbauen muss, migriert Daten, bricht Schnittstellen, schult Teams neu und verliert Monate. Unter den Befragten, die kein Headless-System nutzen, halten 41 Prozent den Preis für zu hoch, 38 Prozent ein solches System für zu kompliziert oder zu entwicklerabhängig. Beides sind Symptome desselben Problems: Modelle, die ohne die Menschen gebaut wurden, die täglich mit ihnen arbeiten.
Wenn Modellierung der Ort ist, an dem die wichtigsten redaktionellen Entscheidungen fallen, dann muss dort auch redaktionelle Kompetenz vertreten sein. Das klingt offensichtlich. In der Praxis ist es die Ausnahme.
Die Rolle, die diese Lücke schließen soll, heißt Content Architect. Sie liegt zwischen Technik und Redaktion. Ein Content Architect versteht, wie Inhalte entstehen, wie sie sich verändern und wo sie ausgespielt werden, und übersetzt redaktionelle Bedürfnisse in strukturelle Entscheidungen und strukturelle Einschränkungen in redaktionelle Möglichkeiten. Andy Fitzgerald beschreibt diesen Ansatz in „Structured Content Design“ als Content-out-Prozess: Er führt vom Inhalt zur Struktur zur Darstellung und kehrt damit den gewohnten Weg vom Screen-Template zum Inhalt um. Inhalte, die so modelliert sind, seien maschinenlesbar und besser vorbereitet auf sprach- und KI-gesteuerte Interfaces.
Entscheidend ist, wer am Tisch sitzt. Contentful empfiehlt Arbeitssitzungen mit jedem beteiligten Team und iteratives Feedback: Das Entwicklungsteam plant und baut, nichttechnische Teams testen und melden zurück. Storyblok formuliert es direkter: Design, Redaktion und Entwicklung sollten gemeinsam am Modell arbeiten. Dahinter steht die Erkenntnis, dass ein Content Model nur funktioniert, wenn es aus vier Perspektiven gleichzeitig gedacht wird: der redaktionellen (Was brauchen wir?), der gestalterischen (Wie wird es dargestellt?), der technischen (Wie wird es gebaut?) und der strategischen (Wie wird es gefunden und verwertet?).

„Die besten Content Models entstehen nicht im Sprint-Backlog, sondern im Gespräch zwischen Redaktion, UX und Entwicklung — bevor das erste Feld benannt ist. In Briefings sehe ich oft das Gegenteil: Modellierung läuft als reine Engineering-Aufgabe. Was dabei entsteht, korrigieren später andere im Interface — was im Modell hätte gelöst werden müssen.“
– Wiebke Wefer, Business Unit Lead Composable Solutions, Triplesense Reply
Modelle müssen sich mitbewegen, denn Inhalte verändern sich: Neue Formate kommen hinzu, bestehende Typen werden erweitert, Anforderungen aus SEO oder Personalisierung erzeugen neue Felder. Iteratives Modellieren heißt: regelmäßig prüfen, anpassen, weiterentwickeln. Das geschieht laufend als Teil der redaktionellen Praxis. Wer ein Modell einmal baut und nie wieder anfasst, hat ein Denkmal errichtet.
Strukturierte Inhalte sind die Voraussetzung dafür, dass Maschinen Inhalte finden und auch verstehen.
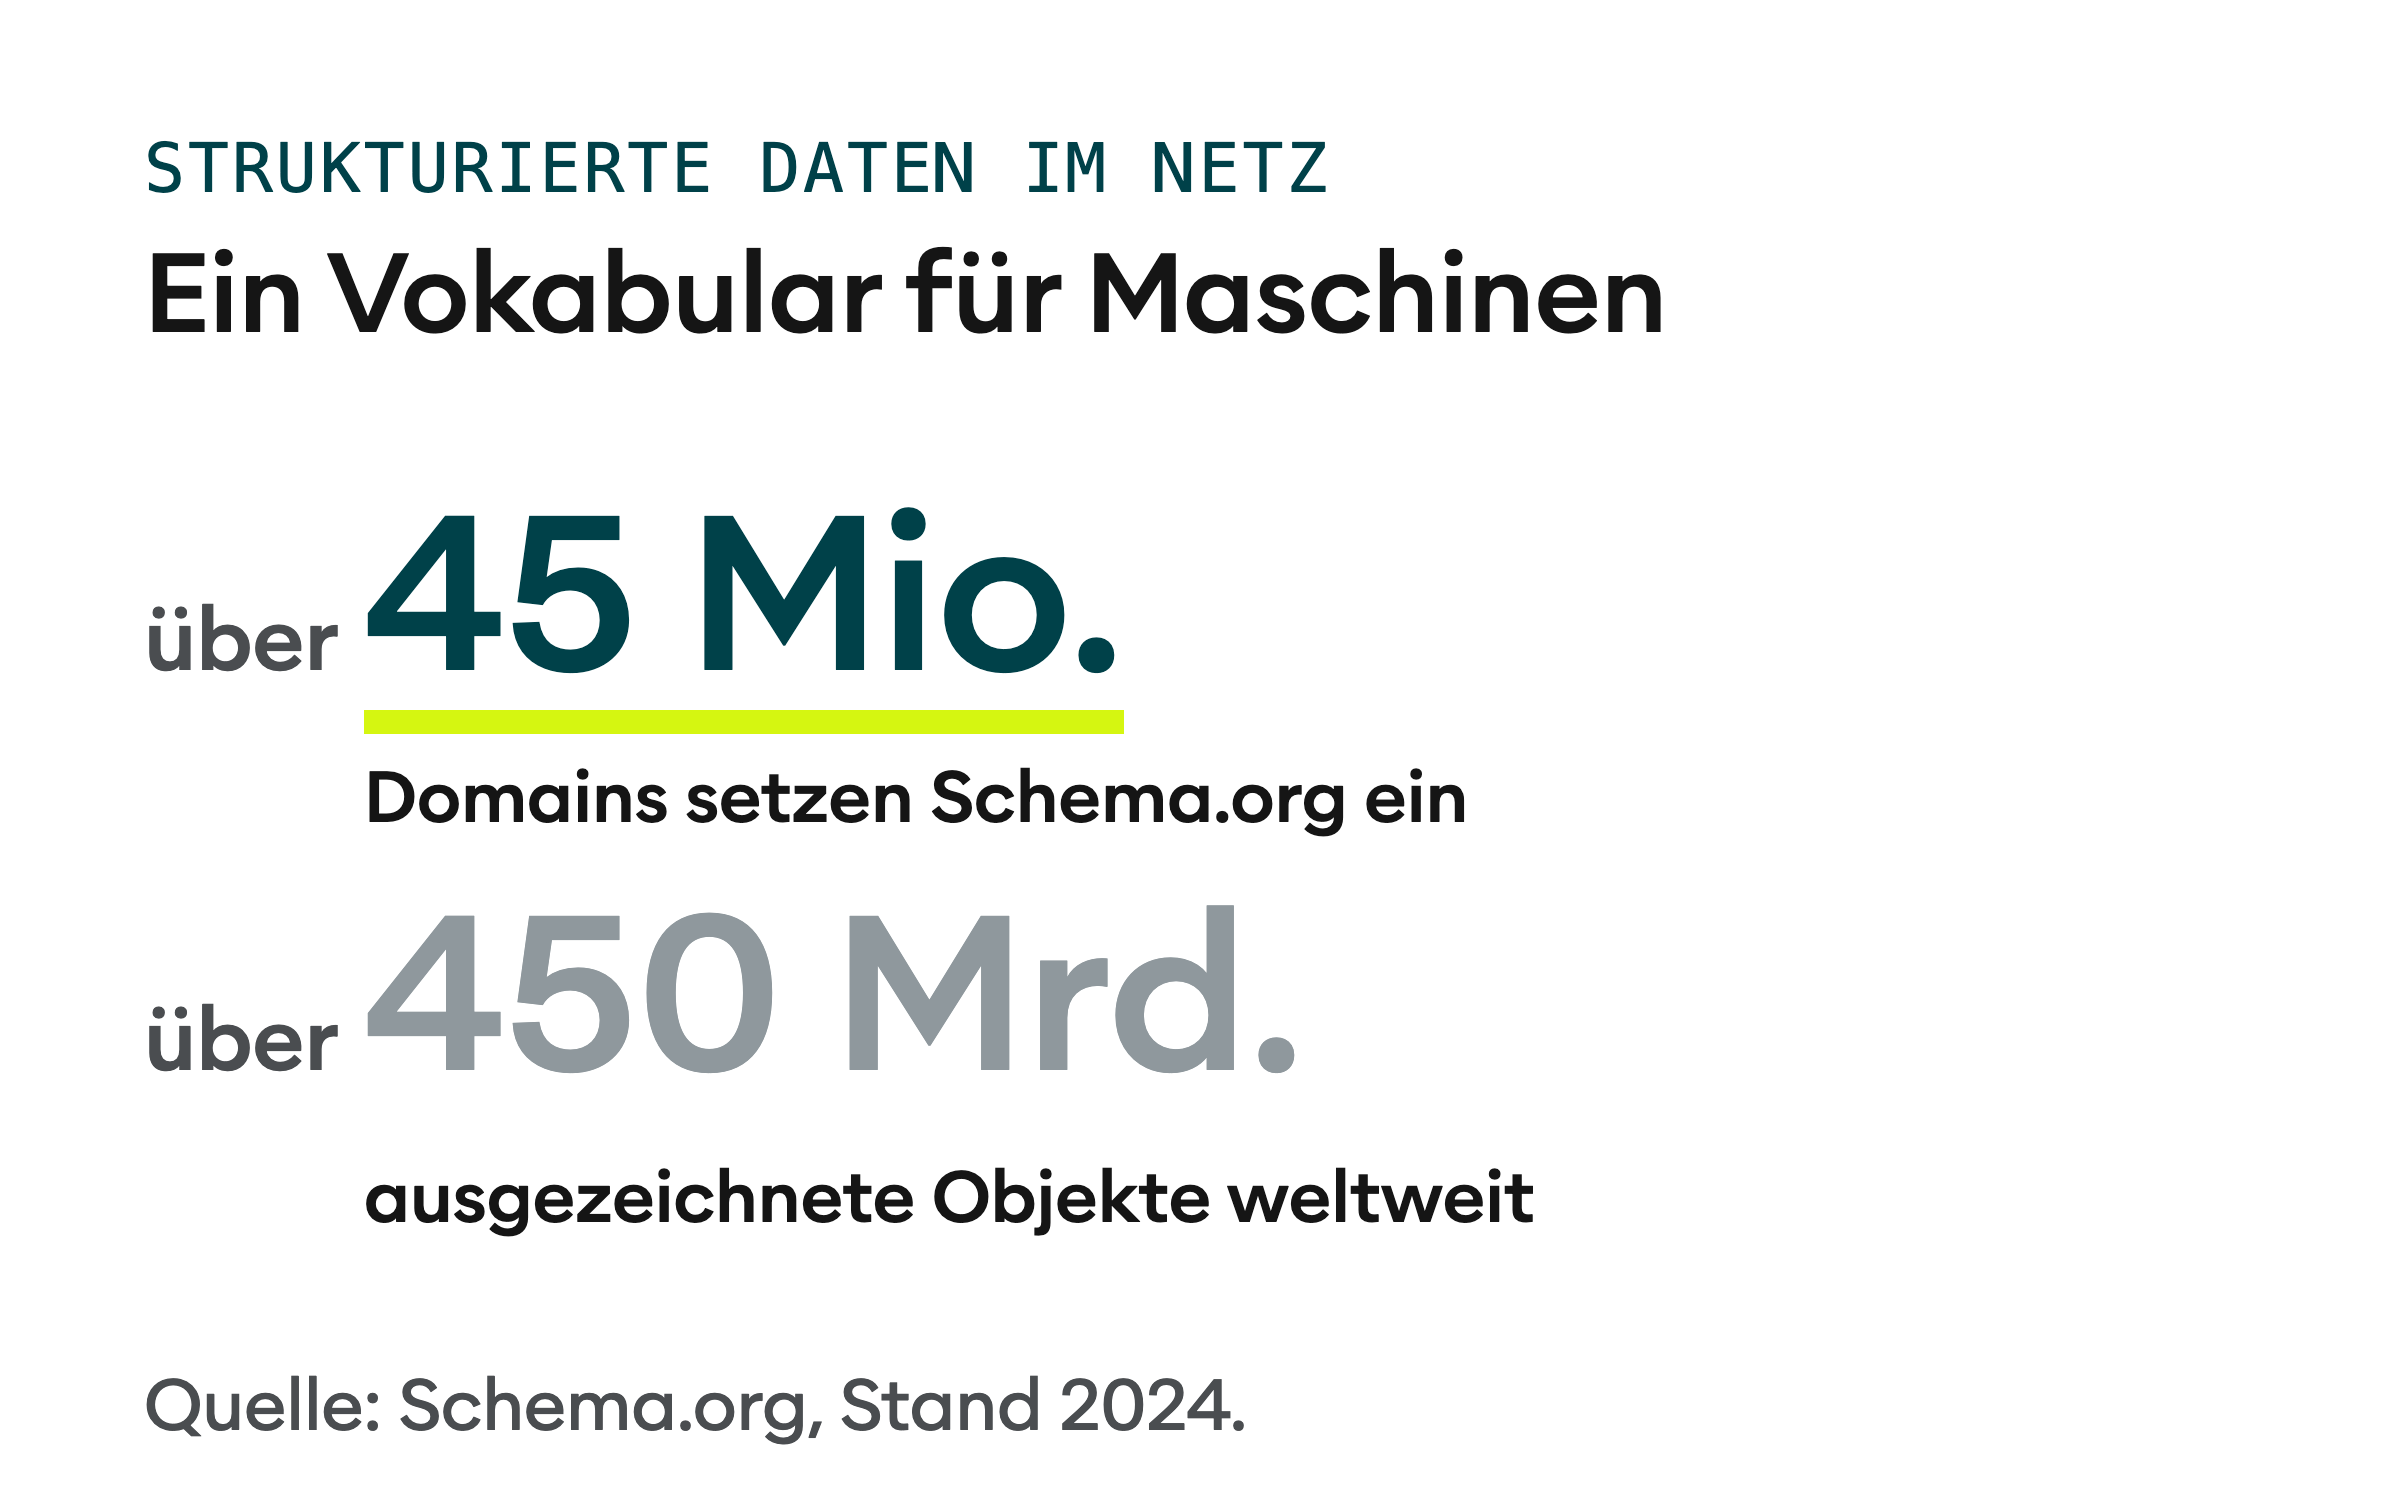
Der sichtbarste Standard dafür ist Schema.org, auf über 45 Millionen Domains im Einsatz, mit über 450 Milliarden Objekten weltweit (Stand 2024). Schema.org stellt ein Vokabular bereit, das Inhalte semantisch auszeichnet: Ein Artikel ist ein Artikel, ein Event ein Event, ein Produkt hat Preis, Hersteller, Bewertung. Google koppelt die Berechtigung für Rich Results an korrektes Markup, JSON-LD ist die empfohlene Implementierung.
Das allein wäre schon relevant. Aber die eigentliche Verschiebung liegt tiefer.
KI-Systeme (von Sprachmodellen über Empfehlungsalgorithmen bis zu autonomen Agenten) arbeiten besser mit strukturierten Inhalten. Sanity beschreibt unter dem Konzept „Agent Context“, wie KI-Agenten Inhalte über standardisierte Protokolle lesen und abfragen können. Das System ist schema-bewusst: Agenten können Felder abfragen, Referenzen folgen und semantisch suchen. Ein Content Model wird damit zur Schnittstelle zwischen menschlich erstellten Inhalten und maschineller Verarbeitung.
Die Forschung bestätigt das. Ein 2025 auf arXiv veröffentlichtes Preprint zu Knowledge-Graph-gestütztem Retrieval dokumentiert messbare Effekte: ROUGE-L stieg von 41,2 auf 46,9, FactScore um 13,6 Prozentpunkte. Übersetzt: Strukturierte Inhalte machen KI-Antworten relevanter und faktisch korrekter. Wer ohne Modell arbeitet, überlässt der Maschine das Raten.
Taxonomien und Knowledge Graphs sind die Weiterentwicklung des Content Models. Ein Content Model beschreibt, was ein Inhalt ist. Taxonomien beschreiben, wovon er handelt. Knowledge Graphs beschreiben, wie er mit anderen Inhalten und Konzepten zusammenhängt. Zusammen bilden sie ein semantisches Netz, das weit über klassische Suchmaschinenoptimierung hinausgeht, hin zu einer Welt, in der Maschinen nach Bedeutung suchen.

Für Content Manager heißt das: Felder, Taxonomien und Referenzen sind die Grundlage dafür, wie sichtbar, verwertbar und zukunftsfähig Inhalte in einer maschinengestützten Welt sind.
Diese Serie heißt „Content als Betriebssystem“. Die Grundidee, kurz: Inhalte sind die Infrastruktur einer Organisation, und Infrastruktur funktioniert nur, wenn jemand die Leitungen pflegt.
Content Modeling ist eine dieser Leitungen. Unsichtbar, entscheidend, chronisch unterbesetzt.
Wer bis hierhin gelesen hat, kennt das Problem oder ahnt es. Die nächsten Teile gehen weiter: was aus Design wird, wenn Inhalte über Schnittstellen fließen, und wer eigentlich zuerst liest, wenn es kein Mensch mehr ist. Es bleibt unbequem und wird dabei klarer.
Falls du diesen Artikel jetzt schließt und denkst, „das müsste mal jemand bei uns angehen“: Du bist jemand bei uns.